


기술동향칼럼
반도체 설계분야 최고권위학회 ISSCC! IEEE SSCS Chapter 임원들과 ISSCC TPC 위원들이 세션별로 리뷰합니다.
김 철 우 교수 고려대학교 전기전자공학부
E-mail ckim@korea.ac.kr
IEEE International Solid-State Circuits Conference (ISSCC)는 매년 2월에 25개국 3천여명의 반도체 칩 설계 관련 연구자들이 모여 최신 연구 성과를 발표하고 미래의 반도체 산업과 기술을 논의하는 가장 권위있는 학회이다. 참석자들의 60% 이상이 기업체에서 올 만큼 실제적인 연구 결과들이 주를 이룬다. 올해는 중국발 코로나19 이슈로 인해 참석자도 많이 줄 것으로 예상했지만 전체적으로 100명 정도만 줄어 코로나19 이슈가 없었다면 참석자가 아주 많았을 것으로 추측해 볼 수 있었다. 코로나19 관련해서 중국(홍콩, 마카오 포함)에서 오는 사람들 미국 입국이 금지되고 소니를 비롯해 출장 금지를 한 기관들이 있어 33명의 발표에 문제가 있었다. 해당 발표들은 참석 가능한 공저자가 발표를 하거나 녹화한 방송으로 발표를 대체하고 질문과 답변은 스카이프로 해결하면서 공백을 메울 수 있었다. 올해 ISSCC에서 우리나라는 작년의 24편 논문 대비 크게 늘어난 36편을 발표하여 미국 다음으로 많은 논문을 발표하였다.
올해 ISSCC 주제는 “Integrated Circuits Powering the AI Era”이다. 지난 수 십 년간 반도체 기술은 엄청난 속도로 발전해 인공지능 시대를 여는 데 핵심적인 역할을 하고 있다. 반도체 회로 및 시스템의 끊임없는 발전이 인공지능과 결합해 우리의 일상 생활에 큰 영향을 미치고 있고 우리가 일하는 방식, 소통하는 방식은 물론 사회 생활의 방식도 변화시킬 것으로 예상된다. 올해 ISSCC에서는 인공지능 관련된 주제 뿐 아니라 퀀텀 컴퓨팅, 광통신, IoT, 바이오 칩 등 새로운 소자 기술부터 새로운 시스템 구현 방법, 그리고 새로운 어플리케이션까지 최신 반도체 회로 설계 기술이 소개되었다.
Plenary talk은 Google, MediaTek, IMEC, IBM TJ Watson Research Center의 전문가들이 발표를 했다. 특히 Google의 Jeff Dean 박사가 “The Deep Learning Revolution and Its Implications for Computer Architecture and Chip Design”라는 주제로 지난 10년간 딥러닝의 발전과 이를 이용한 칩 설계에 대해 발표해 주목을 받았다.
IEEE SSCS 서울 챕터 임원들과 IEEE ISSCC TPC 멤버 중심으로 올해 ISSCC에서 발표된 논문들을 주제별로 정리하여 이번 ISSCC를 한 눈에 파악할 수 있도록 했다. 이와 관련하여 5월 마지막 금요일에 워크샵을 진행하려고 한다. 매해 IEEE SSCS 서울 챕터에서 주최하는 행사로 ISSCC의 전반적인 흐름을 파악하고, 5월의 아름다운 캠퍼스의 낭만을 즐길 수 있는 행사이니 많은 관심과 참여 부탁드린다. ISSCC 심사위원을 역임하신 분이 강사로 많이 참여하여 좋은 논문 작성을 위한 팁도 제공되니, 향후 ISSCC 투고가 목표인 학생들이 참여하면 여러모로 도움이 될 것이다.
홍 성 완 교수 숙명여자대학교 전자공학전공
E-mail hsw0930@sookmyung.ac.kr
Power Converter 분과에서는 네 세션에 걸쳐 총 23편의 논문이 발표되었다. #11 DC-DC Converters (8편)에서는 높은 전압 변환비와 높은 효율을 동시에 달성하기 위한 인덕터/커패시터 결합 구조가 주로 다루어졌다. #18 GaN & Isolated Power Conversion (8편)에서는 GaN 소자를 이용한 converter와 transformer를 이용한 isolated converter가 주로 발표되었다. 또한, #32 Power Management Techniques (5편)과 #34 Biomedical Sensing, Stimulation & Harvesting (2편)에서는 무선전력전송, 에너지 하베스팅 및 low-dropout regulator (LDO) 등의 회로가 발표되었다. 이들 중, #11과 #18의 다수의 논문들이 높은 입력 전압으로부터 낮은 출력 전압을 생성하는 DC-DC converter로 구성되어 있다는 것이 이번 Power Converter 분과의 주요한 특징이라 할 수 있다. 본 후기에서는 총 5편의 논문을 살펴보고자 한다.
#11.1은 12V/24V의 높은 입력 전압을 1V의 낮은 입력 전압으로 변환하기 위한 tri-state double step-down (DSD) power converter를 제안하였다. 이와 같은 입출력 전압을 갖는 어플리케이션에 기존 step-down converter를 사용할 경우, 매우 짧은 duty로 인해 제어의 어려움이 발생하고 high-side와 low-side 스위치 간의 전력 손실 차로 인해 효율을 최적화하기 어렵다는 단점이 있다. 이를 해결하기 위해, 본 논문에서 제안된 tri-state DSD power converter는 앞 단의 switched-capacitor (SC) 구조를 이용해 높은 입력 전압으로 인한 큰 전압 스트레스를 감소시키고 뒷 단의 인덕티브 구조를 이용해 작은 인덕터를 사용하면서도 높은 효율을 얻을 수 있게 하였다. 이와 같은 구조를 이용하여, 24V에서 1V로 전압 변환 시에 88.3%의 효율을, 그리고 12V에서 1V로 전압 변환 시에 91.2%의 효율을 달성하였다.
#11.5는 높은 전압 변환비를 달성하기 위해 인덕터와 커패시터가 결합된 boost converter를 그림 1과 같이 제안하였다. 본 논문에서는 최근 발표된 다수의 인덕터/커패시터 결합 boost converter와는 다르게 hard-charging이 아닌 soft-charging을 이용하여 효율을 증가시켰다. 이러한 구조를 이용하여, 4.5의 높은 전압 변환비에도 불구하고 93.5%의 높은 효율을 달성하였다. 하지만 soft-charging을 위해 두 개의 인덕터를 사용하였다는 점에서는 아쉬움이 남는다.
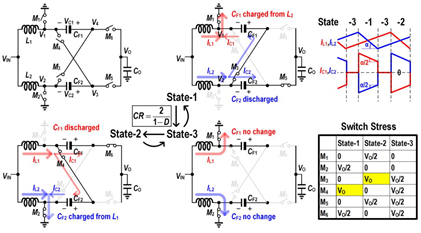
[그림1] #11.5에서 제안하는 boost converter의 구조와 동작 원리
#18.1은 칩 자체적으로 GaN 소자의 열화를 예측하는 기법을 발표하였다. GaN 소자는 작은 온저항과 작은 기생 커패시터를 갖기 때문에 스위칭 소자로 적합하다. 하지만 쉽게 열화되는 특성으로 인해, 지속적인 동작 시 신뢰도가 낮아진다는 문제점이 있다. 일반적으로 GaN 소자에서는 열화의 정도가 온저항의 증가로 나타나기 때문에, 온저항을 측정하여 열화를 예측하는 방법이 사용되어 왔다. 하지만 기존에는 회로가 동작할 때 온저항을 측정할 수 없었거나, 측정할 수 있다 하더라도 칩 외부에 많은 리소스들이 필요했다. 본 논문에서는 회로가 지속적으로 동작하는 상황에서, 칩 자체적으로 온도를 측정하여 트리밍 없이 GaN 소자의 열화를 정확히 예측하는 기법을 제안하였다. 이 기법을 통해 오차율 2.77% 이내에서 정확한 예측을 달성하였다.
#18.6은 48V의 높은 입력 전원에서 1V의 출력으로 60A를 공급하는 isolation type의 3-level half-bridge (HB) DC-DC converter를 제안하였다. 4단계로 동작하는 기존의 HB DC-DC converter와는 달리 본 논문의 HB DC-DC converter에서는 플라잉 커패시터를 사용하여 8단계로 동작을 할 수 있었다. 이를 통해, 스위치에 가해지는 전압 스트레스를 절반으로 감소시킬 수 있었으며, GaN 소자를 사용하지 않으면서도 효율을 증가시킬 수 있었다. 또한, ringing-suppression 회로를 사용하여 플라잉 커패시터의 전압을 1.2% 오차 이내에서 원하는 값으로 유지할 수 있었다.
#32.1은 높은 효율로 전력을 수신하며 동시에 데이터도 수신할 수 있는 전류모드 무선전력수신기를 발표하였다. 본 논문에서는 전력 수신기의 효율을 높이기 위해, 스위치 간의 동작 타이밍을 조절하여 LC 공진기의 잔여 전력을 모두 출력으로 전달하는 방식이 제안되었다. 또한, 전류모드 무선전력수신기를 위한 새로운 데이터 전송 기법인 energy shift keying (ESK)를 제안하였다. 이를 통해, 수신 전력의 감소를 최소화하며 데이터를 수신할 수 있었다. 제안된 기법들로 인해, 13.56MHz의 공진 주파수에서 92.6%의 전력 수신기 효율을, 그리고 100kb/s의 데이터 수신 속도를 달성하였다
배 준 성 교수 강원대학교 전기전자공학과
E-mail baej@kangwon.ac.kr
Biomedical Systems 분야는 Session 26, 28, 34에서 총 19편의 논문이 발표가 되었다. 해당 분야는 on-body wearable과 in-body implantable 응용에 최적화되어 있는 집적 회로 및 시스템을 다루는데 이번 년도에는 저전력 동작과 함께 높은 직접도, 넓은 동적 동작 범위를 갖는 생체 신호 검출 회로와 높은 효율을 갖는 무선 신호 및 전력 전송, 기존에 비해 높은 에너지 효율을 갖는 신호 처리 기법 등이 발표되어 biomedical 응용에 최적화된 다양한 SoC가 발표가 되었다. 본 참가 후기에서는 Session 26: Biomedical Innovations에 대해서 좀 더 살펴보도록 하겠다.
# Session 26 : Biomedical Innovations
Session 26에서는 세션의 이름에서 알 수 있듯이, Biomedical 응용에서 활용되고 있는 최신 기술을 살펴볼 수가 있었다. 다종 신호 센싱을 위한 고집적 SoC, 최적화된 신호처리기법을 통한 Neuromodulation 시스템, 에너지 하베스팅을 통한 무전원 동작 시스템, Delta-Sigmal Modulator를 활용한 신호 획득 등 저전력에 최적화 된 기법이 소개되었다. MediaTek [26.1] 에서는 PPG, ECG, BIOZ, GSR 신호를 센싱할 수 있는 SoC를 55nm CMOS 공정으로 개발하였다. University of Toronto [26.2]에서는 EEG 신호를 기반으로 간질 발작 징후를 실시간으로 판별해 발작 증세를 완화 시킬 수 있는 neurostimulator SoC를 개발하였는데, EEG 신호를 처리할 때, neuromorphic 처리 기법에 기반하여 전력 소모와 정확도를 최적화 하였다. Xian Jiaotong University [26.3]에서도 neurostimulator chipset을 개발하였는데, EEG 신호 검출 시 문제가 되는 동상 모드 interference, electrode DC offset, Stimulate artifact를 효율적으로 제거할 수 있는 아날로그 회로 구조를 제시하고, 2-level classification 방식을 제안하여 저전력으로 동작하는 coarse level classifier의 동작을 통해 fine level classifier의 동작 빈도수를 낮춰 줌으로써 높은 에너지 효율을 달성하였다. Stanford University [26.4]에서는 혈중 저분자 의약품을 위해 사용할 수 있는 chronoamperometric (시간분석법) 센서를 sample-and-hold 기법으로 구성하여 전극의 기생 캐패시터 성분에 영향을 받지 않도록 하였다. 이러한 종류의 연구는 기존의 laboratory에서 사용하는 방식에 비해 간단하고, 부피가 큰 장비를 사용하지 않아도 되는 장점이 있다. Oregon State University [26.5]에서는 사람의 체온을 기반으로 Thermoelectric Generator를 통해 전원을 공급받는 무전원 소스 기반 심박수 검출기 시스템을 구성하였다. 이 때, 사람의 움직임에 의한 영향은 움직임에 의한 신호의 변화에 기반하여 심박을 검출할 수 있도록 하여, 움직임에 강인한 시스템을 구성하였다. 연세대 [26.6]에서는 Gm-C integrator를 기반으로 한 delta-sigma modulator를 통해 증폭단 없이 전극에 직접 연결이 될 수 있는 delta-sigma modulator를 개발하였다. Neural recording에 영향을 줄 수 있는 stimulation artifact 신호를 효율적으로 제거하기 위해 Gm stage의 source degeneration 저항과 feedback node를 함께 위치시켜, 높은 선형성과 dynamic range를 확보하여 기존의 neural recording을 위한 회로 구조에서 최적화된 성능을 보여주었다. Case Western Reserve University [26.7]에서는 PPG 센서를 피부 밑에 위치시키고 wireless capacitive powering을 통해 전원을 공급받는 implantable PPG 검출 회로를 구성하였다. 이 때, PPG 신호를 증폭할 때 기존의 TIA + ADC 구조를 쓰지 않고 전류를 바로 incremental delta-sigma modulator의 입력으로 인가하는 방식을 사용하였다. 최근 들어, 전압 및 전류 신호를 증폭하는데 있어 더이상 IA를 사용하지 않고 delta-sigma modulator를 사용하는 경향을 볼 수 있다. 피부 밑에 위치한 센서는 capacitive powering을 통해 90% 이상의 전력 변환 효율을 얻을 수 있었다고 한다. North Carolina State University [26.8]에서는 trimodal wireless neural interface SoC를 개발하였는데, 16개의 optical / 8개의 electrical stimulation channel을 두고, 16개의 electrical recording channel으로 동작한다. 시스템은 inductive coupling을 통해 전력을 공급받고, 무선 신호 전송 기능도 있어 다양한 기능성을 포함하고 있다. University of Michigan [26.9]에서는 wireless neural recording probe를 구성하는데 있어 외부 기기와 내부 기기 사이에 repeater를 두어 RF 신호를 기반으로 한 전력/데이터 전송을 통해 외부와 연결하고, NIR 신호를 기반으로 하여 repeater와 내부의 Micro-probe와 연결하는 방식을 제안하였다. 이를 통해 공급받은 전력을 통해 probe에서 spiking band power (SBR)을 추출하기 위한 아날로그 신호 처리단을 구성하여 효율적인 동작이 가능하도록 하였다.
본 세션의 highlights 논문은 MediaTek [26.1], University of Toronto [26.2], 연세대 [26.6]로 선정이 되었다. Mediatek은 기존의 최신 Multimodal 신호 획득 SoC (IMEC) 에 비해 작은면적으로 PPG 획득에 있어 10dB 높은 dynamic range와 ECG 획득에 있어 3배더 높은 강인성, 그리고 BIOZ 신호를 획득에 사용되는 전극의 Capacitance를 줄여주어 기존 대비 작은 전극으로도 신호 센싱이 가능하도록 하였기 때문이다. University of Toronto는 neuromorphic 기술을 이용한 resonate-and-fire 기법을 통해 기존의 신호 밴드 필터링 구현에 사용된 FIR 필터 구현과 비교하여 multiplier 없이도 신호의 주파수에 따른 특징점을 저전력/저면적으로 얻을 수가 있었다. 추출된 특징 신호는 다시 BrainForest classifier로 높은 발작 검출 정확도와 낮은 false detection rate를 낮은 에너지 소모를 통해 구성하였다. 연세대는 기존의 IA+ADC 구조에서 IA를 제거하고, Gm-C input 구조를 통해 neural recording에 최적화된 높은 linearity를 갖는 delta-sigma modulator를 개발하였고, 이는 다수의 채널을 갖는 neural recording 응용에서 process 발전에 따라 이득을 볼 수 있는 최적의 구조로 여겨진다.
김 철 교수 KAIST 바이오및뇌공학과
E-mail kimchul@kaist.ac.kr
올해 ISSCC에는 바이오메디컬 회로 논문들이 3개의 세션에 17편 발표되었다. 2018년에는 16편, 2019년에는 13편으로 지난 3년간 꾸준히 10편이상의 새로운 연구결과가 발표되어 바이오메디컬 회로의 연구의 필요성은 계속 지속되고 있음을 알 수 있다. 또한, 바이오메디컬 연구분야 중에서도 올해에는 새로운 응용분야가 더 눈에 뛰어, 바이오메디컬 분야와 반도체회로의 융합 연구로의 연구 흐름을 읽을 수 있다. 본 Biomedical Circuits and Systems II 에서는 Session 28 – User Interaction and Diagnostic Technologies와 Session 34 – Biomedical Sensing, Stimulation & Harvesting 의 두개의 세션에서 발표된 8편의 논문을 간략히 리뷰하고자 한다.
#28.3 논문은 그림 1에서 보이는 완전 집적화된 12인치 웨이퍼 스케일의 CMOS X-ray detector를 설계 제작하여 연세대에서 발표하였다. 대다수의 회로 논문이 하나의 칩을 제작하여 측정 및 발표하는데 반하여, 해당 연구는 144개의 픽셀 칩, 24개의 readout/decoder 칩, 1개의 바이어스 칩으로 구성된 substrate위에 scintillator를 연결하여 개의 칩을 제작하여, 온전히 시스템 레벨의 연구결과를 발표하였다. 시스템으로의 연구성과 뿐 아니라, voltage dependent variable capacitor를 이용한 dynamic range확장, negative-R을 이용한 잡음 저감 기술 등 다양한 회로 기법도 선보였다.
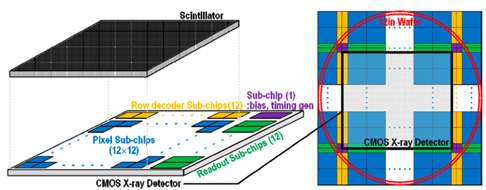
그림 1. CMOS Digital X-Ray Detector
#28.4 논문은 Georgia Tech의 연구 그룹이 다른 여러 그룹과 공동 연구하여 발표하였다. 최근 exoelectrogen의 응용분야가 갈수록 늘어가고 있어, 무수히 많은 exoelectrogen들을 설계 제작하고 있다. 하지만, 다양한 synthesized exoelectrogen variant들을 고속으로 테스트 하는 방안의 부재로, 현재의 throughput은 하루 당 약 100개 정도로 제한된다. 해당 bottle-neck을 해결하고자, 본 연구팀은 voltage excitation, current sensing, complex impedance sensing을 가능케 하는 multi-modality CMOS sensor array를 설계하였다. 해당 연구에서는 각 회로설계 기술도 뛰어나지만, 바이올로지와의 interface를 위해 post-processing에 대한 방안이 눈에 뛰었다.
#34.1 해당 연구결과는 UC Berkeley와 UC San Francisco의 공동연구 결과로 기존의 in vivo dosimeter가 total dose만을 측정하여, 하나의 high energy deposition과 low energy deposition의 결합을 비교 못하며, 이로 인해 정확한 효과를 예측 못하는 단점은 해결하는 mm-scale real-time single-particle dosimeter를 선보였다. 메디컬 의료기기의 단점을 정확히 알고, 이를 CMOS 집적회로 기술로 해결하는 바이오메디컬 융합 연구의 대표적 장점으로 보인다.
#34.2 National University of Singapore (NUS) 에서 발표된 retinal-prosthesis SoC이다. Photoreceptor의 손실로 생기는 retinitis pigmentosa의 문제를 해결하고자 다양한 retinal- prosthesis SoC들이 연구되어 왔으나 기존 연구들의 높은 전력소모, 그로 인한 국부적 열 발생 문제, 흐린 전기 자극 패턴 등의 문제가 제기되었다. 이런 문제들을 해결하고자, neuromorphic image processor를 이용한 outline extraction 기능과, 국부 온도 센서를 이용하여 일정 수준 이상의 온도가 되면, 국부적 파워 게이팅을 통한 전력소모 차단 기능을 추가한 retinal-prosthesis SoC를 선보였다.
#34.3 해당 페이퍼는 임플란트를 위한 무선 전력/데이터 전송을 위해 주로 사용하는 inductive coupling, electromagnetic wave, ultrasound, optic 등이 아닌 10MHz 이하의 magnetic field를 전기 에너지로 변환하는 magnetoelectric transducer를 사용한 방안을 선보였다. Rice university에서 주도하여 연구를 진행하였으며, 그 결과, 최대 3cm의 거리에서 0.16mW(rectifier의 아웃풋 기준)의 파워를 8.2mm3의 볼륨을 가진 임플란트로 전송하였다.
#34.4 UC Berkeley에서 deep tissue oxygen을 모니터링을 위한 이식형 센서를 설계 발표하였다. Ultrasound를 이용하여 무선 전력 전송 및 데이터 통신을 수행하며, 센서의 총 부피는 4.5mm3, 최대 5cm의 거리에서 0.14mW의 전력 전송을 리포트 하였다. 양방향 데이터 통신이 가능하며, 특히 최소 임플란트 깊이 제한 문제를 개선하기 위해 uplink 통신을 2번에 나누어서 5bit씩 전송한다.
#34.5 Human body coupling을 이용한 무선전력전송방안을 NUS에서 선보였다. 몸에 장착되는 다양한 wearable sensor들을 위한 전력 제공 방안은 현재 배터리 혹은 energy harvesting 방안들이 존재한다. 하지만, wearable sensor의 부피가 커지거나, 센서 사용 위치에 제한이 존재한다. 이 문제를 해결하기 위해 본 그룹에선 body-coupled power delivery방안을 해당 논문에서 제시하였다. 뿐만 아니라 해당 기술에 알맞는 detuned impedance booster, Bulk Adaptation Rectifier 등의 방안도 제안하였다.
#34.6 NUS의 같은 연구 그룹이 무선 body channel communication 기능을 포함한 EEG dust를 발표하였다. 해당 연구는 기존 mobile EEG headset의 큰 부피, 유선 연결의 문제를 해결하며 동시에 EEG sensor간의 무선 통신 기능도 제공한다. 특히 EEG센서들 간에 공유되는 reference전극을 제거하여, 완전 무선 EEG 센서를 제안하였다. Common-mode interference (CMI) 에 강인한 회로 기법을 제안하여 약 50Vpp의 CMI환경에서도 심전도 신호 측정 가능함을 증명하였다.
최 재 혁 교수 KAIST 전기및전자공학부
E-mail jaehyouk@kaist.ac.kr
올해 RF와 WLS 분과에는 총 160편의 논문이 제출되었으며, 나란히 80편의 논문에 대한 리뷰가 이루어졌다. ISSCC2020에서 RF 분과는 3개의 regular session을 구성하였으며, 총 25편의 논문을 소개하였다. 북미가 9편의 논문을, 아시아와 유럽이 각각 8편의 논문을 발표하여 균형을 이루었으며, 광대역 5G, 새로운 주파수 영역의 THz 등이 전체 session을 잇는 키워드였으며, 3개의 regular session은 Session 17 Frequency synthesizers and VCOs, Session 24 RF and mm-Wave Power Amplifiers, 그리고 Session 29 Emerging RF & THz Technologies이다.
Session 17 Frequency synthesizers and VCOs는 RF 분과에서 구성한 첫 번째 session으로서 총 9개의 논문이 발표되었다. 전체적인 trend는 고성능화 와 고집적화로 요약될 수 있다. 우선 고성능화의 경우, 5G 통신 상용화로 인하여 유무선 통신시스템이 초고속 데이터 통신을 목표로 하고 있는 것과 궤를 같이 하고 있으며, 이러한 통신시스템에서 요구하는 고주파, 초저잡음 신호 생성을 위한 연구가 활발히 이루어 지고 있는 것으로 해석될 수 있다. 저잡음 성능을 달성하기 위하여 이태리 Politecnico di Milano에서 발표한 #17.2의 15GHz digital Bang-bang PLL은 PD 앞에 DTC를 사용하여 DSM의 quantization noise를 제거하는 방식을 사용하였으며, DTC의 nonlinearity 보상을 위해 piece-wise linearization calibration을 사용한 predistortion을 이용하였다. 핵심 아이디어는 Bang-bang PD를 사용함으로써 발생하는 lock time 열화의 문제를 추가로 Bang bang PD를 하나 더 사용하여 해결하는 것. 실제로 제안한 아이디어를 이용하여 lock time을 크게 줄일 수 있었다. 그러나, 500MHz의 지나치게 높은 reference clock 주파수를 사용한 것은 본 연구의 실용성 및 비교의 공정성을 떨어뜨리는 요소로서 지적 받았다. #17.5 논문도 동 기관에서 발표하였는데, 저잡음 성능 달성을 위하여 Type I subsampling 구조를 사용하였다. 최근 널리 사용되고 있는 digital background 기술을 적용하여 60fs 미만의 초저잡음 성능을 달성하였으나, 역시 500MHz 클락을 사용하여 성능을 평가한 부분이 아쉽다. KAIST에서 발표한 #17.8번 논문은 subsampling PLL의 근본적인 limited lock-in range 문제를 저전력 frequency drift detection loop를 추가하여 해결하였다. 본 기술을 사용하여, 14GHz 출력 신호를 발생할 때 83fs의 지터 성능을 달성하였으며, lock-in range를 8배가량 증가시키는 효과를 획득하였다. 고집적화는 frequency synthesizer 연구 분야의 또다른 키워드다. 무선통신시스템의 data rate을 증가시키기 위하여 carrier 주파수가 커버해야하는 범위가 확장되고 있으며, carrier aggregation의 차수도 크게 증가하고 있는데, 이로 인하여 트랜시버에 집적 되어야 하는 PLL의 개수도 크게 증가하고 있다. 최근 이러한 문제를 해결하기 위한 연구도 널리 진행되고 있는데, KAIST에서 발표한 #17.1과 #17.3 논문이 대표적인 연구 결과라고 할 수 있다. Ring oscillator의 경우 높은 주파수를 생성하기 위해서 트랜지스터의 최소 채널 length를 사용하여 delay cell을 설계해야 하는데 이 경우 높은 flicker corner로 인한 jitter열화 라는 문제를 피할 수 없다. #17.1 논문은 이러한 문제를 I-path gain calibration 방식을 이용하여 해결하였다. Flicker noise는 저주파로 갈수록 높은 에너지가 모여 있게 되는데 이는 출력 주파수가 시간에 대하여 drift하는 형태로 나타나게 된다. 이러한 현상은 loop filter의 p-path 만을 calibration하는 기존 방식으로는 해결이 불가능하였으나 I-path의 gain을 동시에 calibration하는 방식을 사용하여 해결할 수 있음을 보였다. KAIST에서 발표한 또 다른 논문인 #17.3은 ring oscillator 기반으로 낮은 잡음과 낮은 스퍼 성능을 갖는 fractional-N digital PLL에 관한 내용이다. 일반적으로 ring oscillator를 사용하여 저잡음 신호를 발생시키기 위해서는 PLL의 bandwidth를 최대한 확장해야 하는데, 이경우 fractional spur가 증가하는 문제를 피하기 힘들다. Fractional spur를 키우는 주요한 원인 중 하나가 quantization noise를 제거하기 위하여 TDC 앞에 사용되는 DTC의 nonlinearity이다. 본 논문은 <그림1>에서와 같이 DSM에서 생성되어 DTC를 control하는 digital code가 DTC의 nonlinearity를 만나더라도 spur를 발생시키지 않도록 modulation하는 Time-Invariant-Probability Modulator (TIPM)을 개발하였다. 측정을 통하여 ring oscillator를 사용하면서도 기존의 LC oscillator 기반 PLL에 비견할 수 있는 성능을 내는 것이 가능하다는 것을 증명하였다<그림2>.
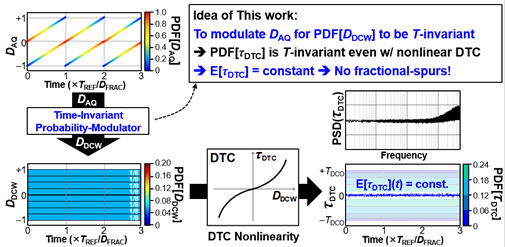
그림 1. #17.3 논문에서 소개된 TIPM 기술의 개념 설명
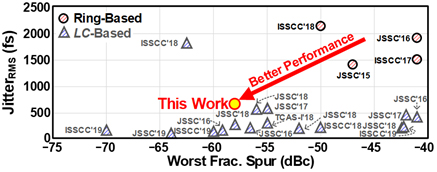
그림 2. #17.3에서 발표된 ring-based PLL과 state-of-the-art PLL 논문들 과의 성능 비교
Session 24 RF and mm-Wave Power amplifiers는 총 8편의 논문으로 구성되었는데, 북미가 5편의 논문을 발표하여 높은 비중을 차지하였다. 안테나에 높은 출력을 공급하면서도 높은 전력효율을 유지하는 밀리미터 대역 Power amplifier는 5G 기술 고도화의 핵심기술이다. 이러한 목표를 위하여 밀리미터 대역 Doherty PA가 대세의 구조로서 다양하게 발표되었다. 또한 PA와 안테나를 하나의 모듈로 개발하는 것이 새로운 추세로 나타났다. #24.2는 가장 주목받은 발표 중의 하나였는데, 재구성이 가능한 series/parallel quadrature-coupler 기반 Doherty PA를 발표하였다. 5G MIMO array를 적합하도록 설계되었으며, mmW 대역에서 21dBm의 Pout, 1.7dB 미만의 3:1 VSWR resilience를 획득하였다. 벨기에의 KU Leuven이 발표한 #24.7 논문은 16nm FinFET을 이용하여 개발된 135GHHz D-Band CMOS PA에 대한 내용을 담고 있다. 초고주파수 대역에서 동작함에도 불구하고 25.6dB의 peak gain, 15dBm의 Psat, 그리고 11.7%의 PAE를 달성하였다.
Session 29는 Emerging RF and THz Techniques이다. 다양한 통신시스템에 의하여 고주파수 대역이 포화되면서 최근 초고주파수 대역의 활용이 주목받고 있다. 300GHz 이상의 sub-THz 주파수를 이용하여 imager, sensor, 초광대역 통신시스템 등을 만드는 기술이 소개되었다. 독일 University of Wuppertal에서 발표한 #29.1 논문은 single pixel imaging에 이용되는 THz radiator array에 관한 내용을 담았으며, 0.42THz에서 9.2dBm의 Pout과 32.8dBm의 EIRP를 달성하였다. KAIST에서 발표한 #29.7 논문도 주목을 받았는데, 0.49THz 대역의 RF 트랜시버를 실리콘에 집적한 imager에 관한 내용을 발표하였다. 고주파 동작에서 전력소모가 큰 frequency divider, VCO 등의 사용을 배제하고 injection locking 기반의 주파수 교정기를 사용하여 전력소모를 최소화하는데 성공하였다.
김 성 진 교수 UNIST 전기전자컴퓨터공학부
E-mail kimsj@unist.ac.kr
Imagers and ToF Sensors에서는 회사에서 8개, 학교에서 2개의 논문을 발표하여 총 10개의 훌륭한 논문이 발표되었다. 2010년 이후로 거리를 측정할 수 있는 time-of-flight(ToF) 센서에 대한 논문이 ISSCC에서 꾸준하게 발표되고 있으며 스마트폰에 탑재되기 시작하고 있어 관련 연구가 매우 활발하게 진행되고 있다. 이를 반영하듯 올해는 10개 중 4개의 논문이 ToF 센서이고 수준이 높아 세션의 이름에도 ToF 센서가 들어갔다. 나머지 6개의 논문 중 4개는 이미지센서 업계 1, 2위 기업인 소니와 삼성에서 발표한 최신 연구 결과들이고 2개는 에너지 효율을 극대화하기 위한 비전 센서의 연구 결과이다. 이번 후기를 통해 6개의 논문에 대해 간략히 살펴본다.
#5.1은 도시바에서 발표한 원거리 고해상도 LiDAR 센서에 관한 논문이다. 도시바는 2018년 ISSCC에서도 LiDAR 센서 연구 결과를 발표하였는데 time-to-digital converter(TDC)와 analog-to-digital converter(ADC)를 같이 사용하는 방식으로 analog front-end(AFE)가 크고 복잡하여 해상도를 높이는데 한계가 있었다. 이번에 발표한 논문에서는 TDC와 ADC를 하나로 합한 VCO 기반의 AFE를 소개하였다. VCO에서 나오는 pulse의 개수를 미분하거나 적분하여 전압 레벨과 시간 정보를 동시에 알아내어 거리를 계산하는 방식으로 동작 원리는 단순하다. 실제 구현 상에서 어려운 점은 VCO의 비선형성 및 jitter 등의 non-ideality와 VCO 간의 mismatch를 줄여서 모든 채널의 AFE가 동일하게 동작하도록 만드는 것이다. 이 논문에서는 VCO에서 나오는 여러 개의 phase 신호를 이용한 pulse-density modulator로 feedback을 구성하여 선형성을 높이고 일정 시간 동안 신호를 지연시켜 VCO가 안정화 되었을 때의 시간을 읽어 노이즈를 줄이는 기법을 선보였다. 그림 1에서 보듯이 촬영된 3D 영상의 화질이 굉장히 좋았고 실제 데모에서도 좋은 시연을 보여주어 많은 관심을 받았다.
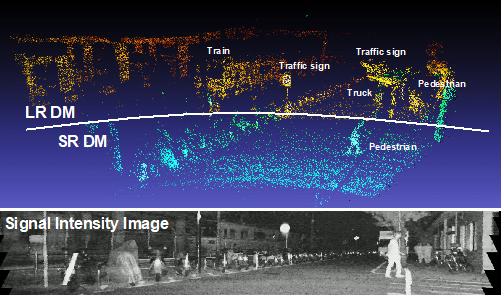
그림 1. LiDAR 센서 출력 영상
#5.3은 대만의 Artilux에서 발표한 논문으로 indirect ToF(I-ToF) 센서를 Ge-on-Si 공정으로 제작하여 많은 관심을 받았다. I-ToF 센서는 LiDAR와는 달리 근거리 고해상도 3D 영상을 얻기에 적합하여 gesture/motion 감지 등에 주로 사용되는데 기존 센서는 실외광에 취약하여 실내에서만 사용된다. Ge는 Si에 비해 밴드갭이 작아 1400nm 수준의 장파장에도 민감하게 반응할 수 있는 장점이 있다. 1300nm에서 1450nm 파장 대역은 태양광이 거의 없기 때문에 이 대역을 사용할 수 있다면 실외광이 전혀 문제가 되지 않는 것이 이 논문의 핵심이다. Si 로직 기판 위에 Ge-on-Si 기판을 3D stacked 공정으로 올려서 제작하였으며 500MHz의 높은 주파수 동작을 달성하였다. 그러나 pixel의 동작 원리나 dark current 레벨 등을 알려주지 않은 점은 아쉽다.
#5.4는 위의 논문과 같은 I-ToF 센서를 성균관대학교와 울산과학기술원에서 발표하였다. 언급한 것처럼 I-ToF는 실외광에 취약한 단점이 있는데 이를 극복하고자 회로를 집적하였으며 다른 문제점인 motion artifact를 줄이기 위해 pseudo 4-tap 동작을 제안하였다. 또한 pinned-photodiode(PPD)의 동작 속도 향상을 위한 trident PPD 구조를 선보여 80MHz의 변조 주파수 동작을 검증하였다. I-ToF 픽셀은 변조한 빛의 위상 차이를 감지하여 거리를 측정하는데 위상을 알기 위해서는 4번의 신호 샘플링이 필요하여 일반적으로 두 개의 연속적인 프레임을 사용하게 된다. 따라서 빠르게 움직이는 물체를 찍으면 artifact가 생기는데 pseudo 4-tap은 두 row의 동작을 반대로 하여 4개의 샘플을 한 프레임에서 받아 해결하는 기법이다. 이 기술에는 edge와 같이 갑자기 거리가 변화할 때 interpolation 문제가 있으나 논문에서 이를 완화하는 방법도 제안하였다.
#5.5 와 #5.6은 삼성에서 발표한 논문들로 소형 픽셀 기술의 정점을 보여주었다. #5.5에서는 삼성의 핵심 기술인 DRAM을 이미지센서에 접목시켜 2.3µm 픽셀 내에 1.4pF이라는 커다란 캐패시터를 집적함으로써 global shutter의 성능을 획기적으로 개선하였다. DRAM 기술의 발전을 고려할 때 계속해서 기술 수준이 올라갈 수 있을 것으로 보인다. #5.6은 세계 최초로 0.7µm 픽셀을 보여주었다. 다양한 공정 기술을 선보였으며 특히 deep trench isolation에 p+ doping을 해서 저항을 낮춤으로써 dark current level을 낮추었다. 0.7µm이지만 기존의 0.8µm 픽셀에 비해 성능을 거의 그대로 유지한 점이 놀라웠으며 어디까지 픽셀 scaling이 진행될지 궁금함을 불러 일으킨다.
#5.10은 비전 센서로 Prophesee와 소니에서 공동으로 발표하였다. 비전 센서는 일반 이미지센서와 달리 이벤트가 있을 때에만 출력을 줌으로써 높은 에너지 효율 및 데이터 압축 기능을 얻을 수 있는 장점이 있어 머신 비전에 적합하다. 여기서 이벤트는 빛의 변화를 말하는 것으로 픽셀에 들어오는 빛의 양이 동일하면 출력을 내지 않고 변화할 때만 감지하여 출력을 내는 것이다. 이 논문에서는 소니의 최신 3D stacked 이미지센서 공정을 사용하여 기존 대비 픽셀 크기를 32% 수준으로 줄이면서도 fill factor를 높여 수광부의 크기를 그대로 유지하였다. 픽셀 및 이벤트 감지 회로는 기존과 유사하나 1280 픽셀에서 나오는 데이터를 40개의 벡터로 바꾸는 인코딩을 도입하여 데이터를 5% 이하로 무손실 압축하는 기술을 소개하였고 이를 통해 최대 1,066MEPS를 달성하였다. 소모 전력은 300MEPS 동작 시 73mW 수준으로 놀라운 에너지 효율을 보여주었다.
채 영 철 교수 연세대학교 전기전자공학과
E-mail ychae@yonsei.ac.kr
Analog Techniques 분과에서는 두 session (3/23)에 걸쳐 16편의 논문이 Oscillator, sensor, V/F reference, amplifier의 주제로 발표되었다. 각 session 모두 300명이 넘는 audience가 참석하였으며 많은 주목을 받았다.
Session 3의 논문 중 주목할 만한 논문은 #3.1의 논문으로 Texas Instrument (TI) 사의 Balk acoustic wave (BAW) 기반의 oscillator (그림1) 이다. 해당 논문은 BAW 와 oscillator를 low cost 단일 package를 통해 구현하였으며, 30ppm의 높은 안정성을 다양한 온도와 stress 환경에서도 보장하는 기술을 선보였다. 해당 기술은 다양한 응용분야에서 crystal oscillator를 대체할 것으로 기대된다.
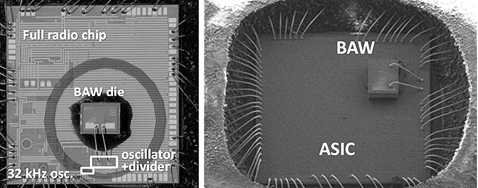
[그림1] BAW oscillator (Paper #3.1)
#3.2 (UIUC) #3.6 (Delft), #3.7 (SiTime) 세 논문은 저항과 BJT 기반의 온도센서 논문으로 모두 embedded 온도 센서를 목표로 설계되었다. 각 논문은 온도 센서 특성을 향상시켜 저면적 (#3.2)과 고효율 (#3.6, #3.7) 을 달성한 것이 특징이다. 온도 센서는 ISSCC에서 지속적으로 발표되어 왔는데, 온도센서의 효율이 매우 향상되어 곧 이론적인 한계에 도달할 것으로 보인다.
#3.4 (Delft)와 #3.5(UIUC)는 CMOS RC oscillator를 제안하였고, 두 논문 모두 온도센서를 내장하여 frequency stability를 향상시킨 것이 특징이다. 각 temperature compensation 기법을 통해 500ppm 정도의 stability를 보장이 가능함을 보였다. 해당 논문들을 통해서 볼 때, 온도센서 내장형 CMOS RC oscillator는 연구의 main trend 로 자리매김할 것으로 보인다.
Session 23의 논문들은 다양한 센서와 고성능 analog 회로를 위한 다양한 technique이 소개되었다. #23.1 (Robert Bosch) 과 #23.6(Delft) 논문은 고성능 Transimpedance amplifier (TIA) 관련 논문으로, #23.1 논문은 장거리 Lidar system을 위한 coding 기법 (phased-coded pulse compression)과 이와 결합된 TIA 기법을 소개하였고, #23.6 논문은 ultrasound probe에 적용된 새로운 형태의 TIA를 소개하였다. TIA 와 관련된 논문은 향후에도 꾸준히 발표될 것으로 보인다.
Class-D audio amplifier는 몇 년간 꾸준히 발표되어 온 주제로, #23.4 (Delft, NXP)와 23.5(NCKU)는 고출력 (#23.4)과 저전력(#23.5) 구현시에 발생하는 비선형성을 보완하는 기법을 제안하였다. 다양한 audio 제품에 대한 수요로 인하여 향 후 몇 년간은 지속적으로 관심을 가지고 지켜볼 필요가 있다.
#23.7(NESTC)과 #23.8(Yonsei)은 Amplifier관련 논문으로 매년 꾸준히 발표되고 있는 분야이다. #23.7 논문은 instrument amplifier (IA)의 CMRR을 높이는 (>130dB) 기법을 소개하였고, #23.8 논문은 매우 높은 선형성 (SFDR=99dB)과 높은 에너지 효율을 동시에 가지는 dynamic amplifier를 제안하였다. 제안된 기법들은 다양한 응용분야에 널리 적용될 수 있을 것으로 보이며, 특히 #23.8논문은 analog technique 분과에서 dynamic amplifier를 처음으로 채택한 것으로, 향후 더 많은 dynamic amplifier기술이 해당 분과를 통해서 발표될 것으로 예상된다.
채 형 일 교수 건국대학교 전기전자공학부
E-mail hichae@konkuk.ac.kr
Data Converters 분과에서는 두 세션 (세션 9, 세션 16)에 걸쳐 총 15편의 논문이 발표되었다. Noise-Shaping ADC를 다룬 세션 9에서는 8편 중 무려 4편이 Noise-Shaping SAR ADC에 관한 논문들이었는데, 최근 몇 년간 유행해온 Noise-Shaping SAR ADC에 관한 연구가 꾸준히 지속되는 것을 확인할 수 있었다. 그 외 매우 높은 해상도를 보이는 continuous-time 기반 ∆Σ ADC 두 편도 포함되어 있었다. 세션 16의 경우 상당수가 고속에서 동작하는 ADC에 관한 것들이었는데, 그 방법들이 흥미로웠고 beyond 5G통신용 ADC에 대한 관심이 매우 높은 것을 확인할 수 있었다. 예년에 비해 dynamic amplifier나 ring amplifier를 활용한 ADC의 수가 눈에 띄게 줄었고, 전반적으로 산업체보다는 학계에서 발표한 논문들이 많았다.
#9.2 는 연세대학교에서 발표하였는데 continuous-time ∆Σ modulator에 Chopped Negative-R을 적용하여 noise floor를 낮추고, Tri-level FIR DAC을 사용하여 피드백에서 발생하는 비선형성을 크게 낮추었다. 103.5dB의 dynamic range와 186dB의 FoM을 달성하여 오디오 스펙을 기준으로 한 ADC중 가장 높은 FoM을 달성하였다.
#9.3 는 University of Texas, Austin 에서 발표한 논문으로 Noise-Shaping ADC에 관한 논문을 가장 활발히 발표하고 있는 Nan Sun 교수 연구실의 논문 중 하나이다. Media Tek에서 2019년 ISSCC에 발표했던 핑퐁 구조의 Noise-Shaping ADC의 변형 구조에 자체 개발한 MES알고리즘을 적용하여 매우 높은 FoM을 달성하였다. 기술적으로 크게 새로워 보이지는 않지만 기존 기술들의 조합과 개선을 통해 성능을 크게 높인 부분이 주목할 만하다.
#9.4 는 University of Michigan 에서 발표한 논문으로, Noise-Shaping ADC를 Cascade 구조로 구성하였다. 전형적인 ∆Σ ADC에 사용되던 Cascade 구조를 Noise-Shaping ADC에 적용함으로써 4차 NTF를 구성할 수 있었고, 이를 통해 상대적으로 낮은 OSR에서도 매우 높은 SNDR을 달성하였다.
#9.5 는 #9.3과 같이 University of Texas, Austin에서 발표한 논문이며, dynamic amplifier를 closed-loop으로 구성하여 PVT 변화에 매우 취약했던 dynamic amplifier를 개선하였다. 개선된 dynamic amplifier를 2차 Noise-shaping SAR ADC에 적용하여 상당히 높은 FoM을 달성하면서 PVT 변화에도 민감하지 않다는 장점을 보여주었다.
#9.6 은 University of Macau에서 발표한 논문으로 예전 VLSI symposium에 발표된 적이 있는 0-1 MASH SAR-assisted pipelined ADC를 변형한 ADC에 관한 내용이다. 높은 차수의 NTF를 구성하여 해상도는 높이고, 두 채널의 pipelined ADC를 time-interleaving하여 변환 속도 또한 높인 것이 매우 인상적이었다.
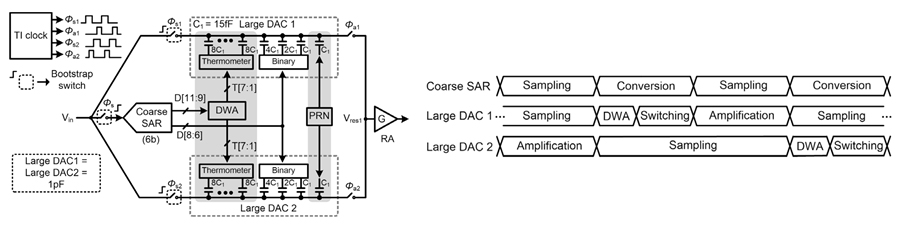
<세션 9.6> Time-interleaving과 pipelining구조가 적용된 Noise-Shaping SAR ADC
#16.1 은 Analog Devices에서 발표한 논문으로 18GS/s 의 초고속 ADC에 관한 연구 결과이다. 8 채널의 sub-ADC들로 구성되는데 고속 신호를 처리해야 하므로 sub-ADC들보다는 입력 신호를 받아서 전달하는 THA와 digital calibration 방법에 더 초점이 맞춰져 있다. Calibration이 매우 복잡해보이나 최근 고속 ADC들과 비교했을 때 샘플링 속도가 훨씬 높으면서도 가장 높은 FoM을 달성하였다.
#16.3 은 University of Macau에서 발표하였는데 한 개의 채널만 사용하여 높은 샘플링 속도를 달성할 수 있는 pipelined ADC에 관한 것이었다. 기존 pipelined ADC에서 각 스테이지가 수행하는 work flow를 간단하게 최적화함으로써 pipelining의 효율을 더 높였다. 단일 채널만 사용하여 샘플링 속도를 크게 증가시키기는 하였으나 6bit의 해상도는 다소 아쉬웠다.
#16.5 는 Tsinghua University에서 발표한 논문으로 고해상도 SAR ADC가 흔히 겪는 kT/C 노이즈 문제를 해결할 수 있는 방법을 제시하였다. 기존 증폭기에서 오프셋을 제거하는 방법과 유사한 방법으로 kT/C 노이즈를 제거한다고 언급하였는데, 모든 주파수 대역에서 제거되는 것이 아니었으며 일반적으로 적용될 수 있는 방법인지에 대해서는 의문이다.
#16.6 는 Analog Devices에서 발표한 논문인데, continuous-time pipelined ADC에 inherent anti-aliasing기능이 탑재되어 있고 VCO를 기반으로 하는 등 다양한 기법들이 조합되어 있다. RF신호를 직접 A-D변환할 수 있는 ADC개발을 목표로 하다보니 anti-aliasing기능이 중시되어 이런 형태로 구성한 것으로 보인다. #16.1과 마찬가지로 digital calibration이 차지하는 비중이 매우 높다.
송 대 건 교수 경북대학교 전자공학부
연구분야 Digital VLSI/CADE-mail tsong@knu.ac.kr
매년 2월의 ISSCC는 각 회사들에서 설계한 processor들을 자랑하는 자리이다. 올해도 각 회사들에서는 자신들이 발표한 칩에 대해 기술적인 challenge가 상당했던 부분들에 대한 상세한 발표가 이루어졌다. 작년에 이어 올해도 Machine Learning에 대한 관심은 상당했고, 흥미로운 Domain-specific 프로세서들도 소개되었다. 몇몇 주요 논문들에 대해 아래에 정리한다.
#Session 2: Processors
[2.1] AMD에서는 2세대 ZEN processor가 어떻게 설계가 되었는지에 대해 다양한 관점에서 정리를 했다. 흥미로운 부분이 몇 가지 있었는데, TSMC의 7nm FinFET을 사용하면서 생겼던 physical design과 관련된 issue들에 대해 제법 상세하게 설명했다. 추정컨데, TSMC의 7nm 공정이 엔지니어에게 상당한 기술적인 challenge를 안겨주었으며, 14nm (ZEN1)에서 7nm으로 넘어가는 데에 TSMC에서 공정상의 변화가 상당히 많았으리라 본다. [2.2, 2.3] 각 회사에서 자사의 Chiplet architecture에 대해 여기서 설명했는데, 각 회사들 별로 사용하는 명칭은 조금씩 다르지만 향후의 고성능 칩/시스템 설계가 2.5-D 기술로 이루어져야 된다는 것에 대한 이견은 없는 것 같다. 상용 제품들이 양산되기 시작한 2.5-D 기술은 이제 제법 완성된 듯 보인다. [2.4-2.7] 각 회사에서 자사의 최신 processor 들을 설명했다. 이제는 모바일 AP에서 필수가 되는 NPU[2.4], 새로운 FLL(Frequency-locked Loop) 구조[2.5], 자동차 MPU의 Vision 가속기 (VPAC, DMPAC) [2.6], 그리고 서버 시스템에서 floorplanning으로 어떻게 성능향상을 이루는지[2.7]가 각 논문의 주요 포인트다.
#Session 8: Highlighted Chip Releases
[8.1] 개인적으로 이번 ISSCC에서 가장 흥미롭게 본, Intel이 어떻게 기술 혁신을 이루고 있는지를 잘 보여주는 논문이다. 본 논문을 통해 Intel은 산업계에서 최초로 3D IC(3차원 집적회로)를 구현해냈다. “Hybrid Core”라는 자체 Core 정의를 통해 전력 소모량이 큰 프로세서 관련 모듈들을 하나의 chip으로 묶고(위), 상대적으로 전력 소모량이 적은 모듈들을 하나의 chip으로 묶어(아래) 3차원 IC로 구현하였다. 전력 소모량이 큰 chip 위에 heat sink를 놓으면서 3D IC가 가지고 있는 열 발산 문제를 잘 해결하였다. 이러한 3차원 설계의 동작을 모델링 하기 위하여 아키텍쳐, physical design, 열분석, Channel I/O, Ball Map, TSV model 등 얼마나 많은 분야의 엔지니어들이 같이 고민했는지를 보여주는 흔적들이 논문에 잘 녹아있다 (그림 1). 그 밖에 논문들에서는 각 회사들이 7nm 기술을 이용하여 어떻게 자사 최고의 CPU/GPU를 설계했는지 잘 설명하였다. [8.2-8.4]
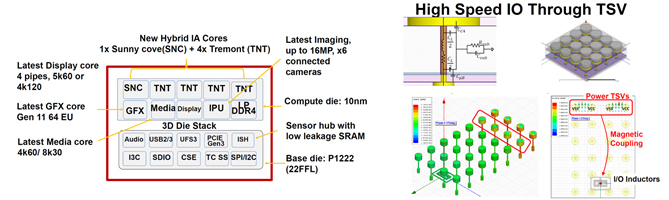
그림 1 – [8.1] Intel의 Lakefield 프로세서에 새로 도입된 3차원 집적회로 아키텍쳐 (좌)와 분석방법 (우)
#Session 21: Domain Specific Processors
[21.1] 유전체(genome)의 염기서열을 가속하는 프로세서를 제안하였다. 염기서열의 배열 문제는 GPU를 이용하여도 수일이 걸리는 문제이며, 이를 제안한 알고리즘으로(그림2) 40분 이내에 분석을 할 수 있게 하였다. 특정 문제를 해결하는 데에 특화된 프로세서/시스템이 얼마나 유용한지를 잘 설명하였다. [21.2] 자율주행 로봇을 위한 저전력 프로세서를 제안하였다. 제안한 프로세서는 기존의 IDA 알고리즘이 가진 지도의 크기가 증가함에 따라 복잡도가 기하급수적으로 증가하는 문제를 해결한다. [21.3] 에서는 차량용 저전력 image 프로세서를 제안하였다. 제안한 프로세서의 성능향상(2.1x)과 저전력 (-55.3%)을 보임으로서 작년의 reference보다 우월함을 잘 설명하였다. (그림 3)
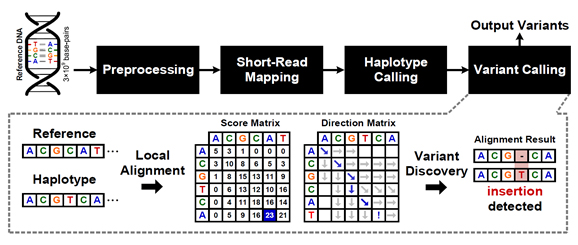
그림 2 – [21.1] 염기서열 가속 프로세서를 위한 알고리즘
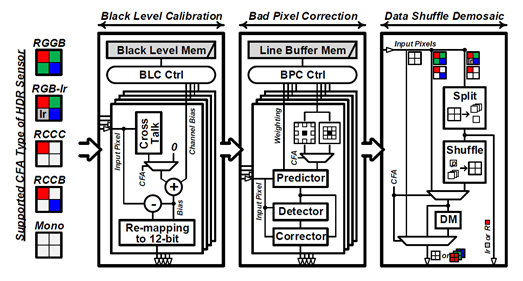
그림 3 – [21.3] 차량용 저전력 image 프로세서의 아키텍쳐
나 태 희 교수 인천대학교 전자공학부
E-mail taehui.na@inu.ac.kr
Memory 관련 논문은 Session 13: Non-Volatile Memories, Session 15: SRAM & Compute-In-Memory, Session 22: DRAM & High-Speed Interfaces에서 각각 5편, 5편, 3편으로 총 13편의 논문이 발표되었다. 예년과 마찬가지로 고성능, 고집적, 저전력을 달성하기 위한 내용들이 주를 이뤘으며, 상용 메모리인 DRAM과 NAND Flash memory 관련 논문은 기업체에서 주로 발표하였으며, 인공지능 연산의 에너지효율을 높이기 위한 Computing-In-Memory (CIM) 관련 논문은 학교에서 주로 발표하였다.
Session 13에서는 삼성, SK하이닉스, 키옥시아(구 도시바)에서 3D NAND Flash 관련 논문을 각각 1편씩 발표했고, TSMC와 NTHU에서 STT-MRAM 관련 논문을 1편씩 발표했다. #13.1 논문에서는 삼성에서 1Tb QLC(4b/cell) 92단의 5세대 V-NAND flash memory를 선보였는데, program 도중 진행되는 verify 수 감소 및 adaptive read scheme을 이용하여 program과 read 성능을 높였다. 현재 mainstream인 TLC(3b/cell)가 조만간 QLC로 바뀌길 기대한다. #13.2 논문에서는 SK하이닉스에서 삼성과 마찬가지로 1Tb QLC 92단 3D V-NAND flash memory를 선보였는데, 성능 향상을 위해 high gain BGR 회로와 accurate sensing scheme을 사용하였으며, 면적 효율을 높이기 위해 peripheral circuit을 memory cell array 아래에 배치하는 PUC 기술을 적용하였다. #13.3 논문에서는 TSMC에서 22nm 로직 공정을 이용한 32Mb embedded STT-MRAM macro를 선보였다. 기본 logic CMOS 공정 대비 2 extra mask를 사용하여 MRAM process를 구현하였고, 1T4R reference cell, BL clamping NMOS triming 기반 SA, adaptive write-verify 기반 smart write을 바탕으로 10ns read speed, 1M write cycle, 10 years retention at 150°C를 달성하였다. #13.4 논문에서는 NTHU에서 short read access time과 high BW 특성을 필요로하는 security용 1Mb STT-MRAM macro를 선보였다. High BW, short read access time 및 low peak current를 위해 multibit sense amplifer를 제안하였으며, speed up을 위해 near-memory computing 구조를 제안하여, 42.6GB/s BW & 2.75ns access time을 달성하였다. #13.5 논문에서는 키옥시아에서 128Gb SLC(1b/cell) 96단의 고성능 NAND flash memory를 선보였으며, flexible suspend operation과 novel optimized floorplan을 이용하여 tPROG=75us와 tR=4us을 달성하였다.
Session 15에서는 TSMC에서 SRAM 논문 1편을 발표했으며, SRAM을 이용한 CIM 논문 3편과 ReRAM을 이용한 CIM 논문 1편이 발표되었다. CIM 관련 논문은 모두 대만의 NTHU와 TSMC에서 발표되었다. #15.1 논문에서는 TSMC에서 EUV와 high-mobility FinFET을 이용한 5nm 135Mb SRAM array를 선보였다. Assist circuit의 area overhead를 줄이기 위해 metal coupling/charge sharing capacitor를 이용한 negative BL & lower cell VDD scheme과 flying BL architecture를 제안하여 300mV 이상의 VMIN 감소 및 30Mb/mm2 bit density를 달성하였다. #15.2 논문에서는 NTHU에서 inference를 위한 forward computation 뿐만 아니라 training을 위한 backward propagation을 지원하는 28nm 6T SRAM 기반 CIM macro를 선보였다. 에너지 효율을 높이기 위해 two way transpose multiply cell과 small offset gain enhancement sense amplifier을 제안하여 7-61.1TOPS/W 에너지효율을 달성하였다. #15.3 논문에서는 TSMC에서 7nm FinFET을 이용한 8T SRAM과 Flash ADC 기반 4b-input x 4b-weight CIM macro를 선보였으며 351 TOPS/W 에너지효율 및 372.4 GOPS throughput을 달성하였다. #15.4와 #15.5 논문에서는 NTHU에서 high precision multibit MAC computing을 위해 각각 22nm ReRAM 기반 2Mb 4bIN-4bW-11bOUT 비휘발성 CIM Macro와 28nm 64KB 6T SRAM 기반 8bIN-8bW-20bOUT CIM macro를 선보였다.
Session 22의 DRAM 관련 논문은 모두 기업체(삼성2, SK하이닉스1)에서 발표하였다. #22.1과 #22.2 논문에서는 삼성에서 2세대 10nm DRAM process를 이용한 1.1V 16GB 8-high HBM2E (HBM2 Extension) DRAM과 1.05V 12GB LPDDR5 SDRAM을 선보였다. #22.1은 data-bus window-extension technique, 안정적 동작을 위한 power delivery network 및 synergetic on-die ECC scheme을 사용하여 640GB/s (5Gb/s/pin)의 data rate을 달성하였으며, #22.2은 hybrid bank architecture, skew-tolerant scheme, bus based read DBI_AC scheme 및 speed-boosting technique을 사용하여 8.5Gb/s/pin을 달성하였다. #22.3 논문에서는 SK하이닉스에서 2세대 10nm DRAM process를 이용한 128Gb 8-high HBM2E DRAM을 선보였으며, bus-flip 기반 power dispersion technique을 통해 thermal 문제를 개선하고 pseudo quarter bank structure를 이용하여 512GB/s를 달성하였다.
이 규 호 교수 UNIST 전기전자컴퓨터공학부
E-mail kyuho.jsn.lee@unist.ac.kr
공통 약어 정리
- - ML: Machine Learning
- - DL / DNN: Deep Learning / Deep Neural Network
- - CNN: Convolutional Neural Network
- - RNN: Recurrent Neural Network
- - GAN: Generative Adversarial Network
Machine Learning은 High-performance ML(Session 7)과 Low-Power ML(Session 14) 총 두 개의 세션으로 구성되었다. 사용하고자 하는 target application 및 platform에 따라 요구되는 하드웨어 사양이 상이한 만큼 두 개의 세션으로 구성되어 논문을 선택적으로 볼 수 있다. 특히 단일 CNN과 RNN의 추론 가속에 집중된 기존의 프로세서들과 달리 복수 개의 DNN을 학습하고 추론하는 GAN 프로세서가 발표된 점이 돋보였다. 이번 후기를 통해 총 7개의 논문에 대해 간략하게 살펴보고자 한다.
#7.1은 MediaTek의 논문으로 스마트폰 등 엣지 디바이스에서의 DL 가속을 목표로 한다. 스마트 폰에서 DL 가속기는 1~10GB/s의 메모리 대역폭 하에 소비전력이 1W 미만이어야 하므로 메모리 접근 횟수를 최소화하는 power-efficient DL 가속기를 제안했다. 두 개의 DL 가속기 코어에 1MB의 상당히 큰 L2 SRAM 메모리를 집적하여 각 레이어의 activation과 weight를 공유한다. 컨볼루션 엔진은 1~8 출력 채널에 대해 convolution 연산을 수행할 수 있고 다양한 MAC 연산(8b, 16b, FP16)을 지원하며, 각 연산 유닛은 두 개의 accumulator를 집적하여 dual-block 모드를 지원한다. 또한 안드로이드 Neural Network API가 사용하는 양자화 기법인 ASSYMM-Q를 가속하며 zero-skipping, weight quantization 등의 테크닉을 지원하도록 설계되었다. 마지막으로 데이터의 재활용 비율을 높임으로써 메모리 대역폭을 줄이기 위해 타일 단위의 처리법과 layer-fusion 기법 및 RL 기반의 컴파일러 최적화 기법을 제안하였다. 실제 스마트폰 집적을 목표로 만든 칩이라 굉장히 거대한 규모이며 다양한 스택에서의 아이디어가 제안된 완성도 높은 칩이라는 장점이 있다.
#7.2는 Alibaba 논문으로 CNN에서 자주 사용되는 img2col() 변환의 부담을 줄이고 프로그램 가능한 서버 향 neural processing unit을 제작하였다. 연산 능력을 최대화하기 위해 DRAM 대신 192MB의 거대한 SRAM을 4개의 코어에 균등히 배분하여 집적하고 데이터를 양자화하여 필요시 sparsity engine에서 decoding 하여 사용한다. 범용성을 위한 ISA와 컴파일러를 제작하여 peak performance를 달성하는 데에는 높은 성과를 보였으나, 하드웨어적인 아이디어가 비교적 자세하지 않은 점이 아쉽다.
#7.3은 Tokyo Institute of Technology에서 발표한 Simulated Annealing 프로세서이다. 이 프로세서는 Ising 모델에 기반하여 global optimization을 찾는 조합 최적화에 사용되며 한 번의 Monte Carlo step 당 여러 개의 스핀을 동시에 업데이트하는 것이 목적이다. Ising Spin System 대신 Stochastic Cellular Automata Spin System을 차용함으로써 fully-connected spin을 활용하여 Monte Carlo step 마다 spin 업데이트를 병렬적으로 처리하였으며, SRAM 기반 Near Memory 구조의 차용으로 fully-connected spin의 annealing을 빠르게 처리한다. 또한 갓 변한 spin 업데이트만을 처리하고 기존의 확률은 재활용하여 업데이트 시간을 단축시킨다. 대부분의 ML 하드웨어가 DL/DNN을 가속하는 데 초점을 두는 반면 이 프로세서는 최적화 문제를 해결한다는 것에 의의가 있으며 차세대 기술로 떠오르는 Quantum Computing에 적용될 수 있다.
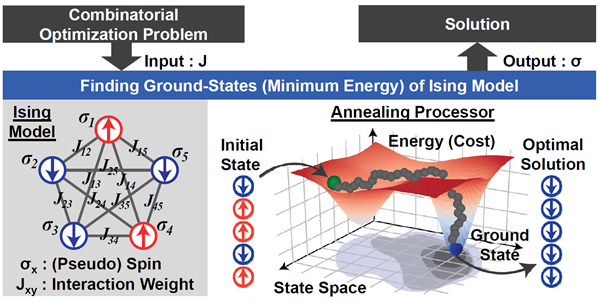
그림 1. Ising Model 에 기반한 최적화 모식도
#7.4는 KAIST의 GAN 프로세서로서 구두 발표와 데모 세션에서 많은 이목을 끌었다. 기존의 DNN 가속기는 Discriminative Model 기반이지만 GANPU는 서로 경쟁하는 두 개의 DNN으로 새로운 답을 만들어내는 프로세서이며 이를 위해 ‘추론’과 ‘학습’이 모두 가능하다. 본 프로세서는 여러 개의 DNN을 지원하기 위한 Adaptive Spatio-Temporal Workload Multiplexing 기법과 높은 throughput의 학습과 추론을 위해 입출력의 activation sparsity skipping의 적용 및 지수만 사용한 ReLU Speculation 기법을 제안하여 소프트웨어-아키텍처-마이크로아키텍처 전 레벨에서 아이디어를 제시하였다. Adaptive Spatio-Temporal Workload Multiplexing은 모든 workload를 시공간 축에서 나누어 연산 코어에 직렬/병렬적으로 할당하며, output activation 값을 예측하여 ‘0’인 경우 MAC 연산을 건너뛰는 메커니즘을 제안하였다. 마이크로아키텍처에서 소프트웨어까지 전반적인 최적화를 통해 정확도를 유지함과 동시에 throughput과 에너지 효율을 향상시켰으며, 이는 낮은 전력 소모로 User-dedicated Experience 등 모바일/엣지 디바이스에 활용이 가능할 것으로 기대된다.
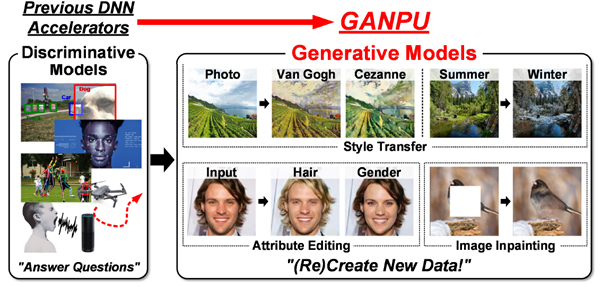
그림 2. 기존 DNN 가속기와 GANPU의 모델 및 능력 비교 모식도
#14.1은 중국의 Southeast University에서 발표한 초저전력 Keyword-Spotting 프로세서이다. Keyword-Spotting은 애플의 Siri와 같은 자연어 처리에서 특정 단어를 감지하여 always-on으로 동작하는 시스템이기에 5W 미만의 전력을 소비해야한다. 따라서 메모리와 연산을 적게 사용하면서 음성의 특징점을 추출하는 Mel Frequency Cepstrum Coefficient (MFCC) 회로와 Binarized DSCNN을 함께 집적하여 연산량과 데이터 저장 공간을 줄이고, near-threshold voltage (NTV) 기법과 낮은 주파수를 사용하였다. MFCC에 사용되는 FFT를 직렬 파이프라인 구조로 사용하여 메모리와 소비전력을 줄이고 로그 연산을 Look-Up-Table로 대체하였다. 또한 NTV 동작을 위해 낮은 누설 전류를 갖는 레지스터 파일 기반 메모리를 제작하였다. 소비전력 측면에서는 우수한 성과이나 매우 작은 특정 네트워크에만 특화된 논문이라 아쉬움이 남는다.
#14.2는 Tsinghua University에서 발표한 저전력 CNN 비디오 프로세서이다. 정지 화면이 아닌 동화상 비디오는 연속된 프레임 간 temporal coherency가 존재하므로 activation similarity를 재활용하는 연산기와 on-/off-chip 메모리 간 데이터 통신량을 줄이기 위한 mixed-bit-width difference-frame data codec을 제안하였다. 작은 전력과 프레임당 에너지를 소비하지만 감산영상 (difference image)의 특성상 빠르게 변하는 이미지 시퀀스에서는 데이터 재활용률이 떨어지며 reference frame update 문제가 생길 수 있다.
#14.3 Tsinghua University에서는 Computing-in-Memory (CIM) 기법의 CNN 하드웨어를 소개하였다. 기존의 CIM 프로세서는 메모리 매크로 자체에 초점을 두었기에 sparse 데이터를 효과적으로 처리할 수 없었던 점을 해결하고자 dynamic sparsity performance scaling 구조를 통해 sparsity를 가속하고 소비전력을 줄이는 노력을 기울였다. 또한 데이터 재활용률과 매크로 사용률을 높이기 위해 다른 레이어의 값들을 상황에 따라 매핑/스케줄링 하고 연산 유닛을 power-off 하는 기법을 제안하였다. 메모리 매크로에서의 연산을 고려한 기존의 CIM 프로세서보다 효율적인 sparse 데이터 처리를 위한 회로의 아이디어가 새로웠다.
